
앤트로픽이 직원 201명의 책 교환을 클로드 에이전트에게 맡겼습니다. 에이전트는 5분 대화로 취향을 파악한 뒤 서로 협상해 책을 바꿨습니다.
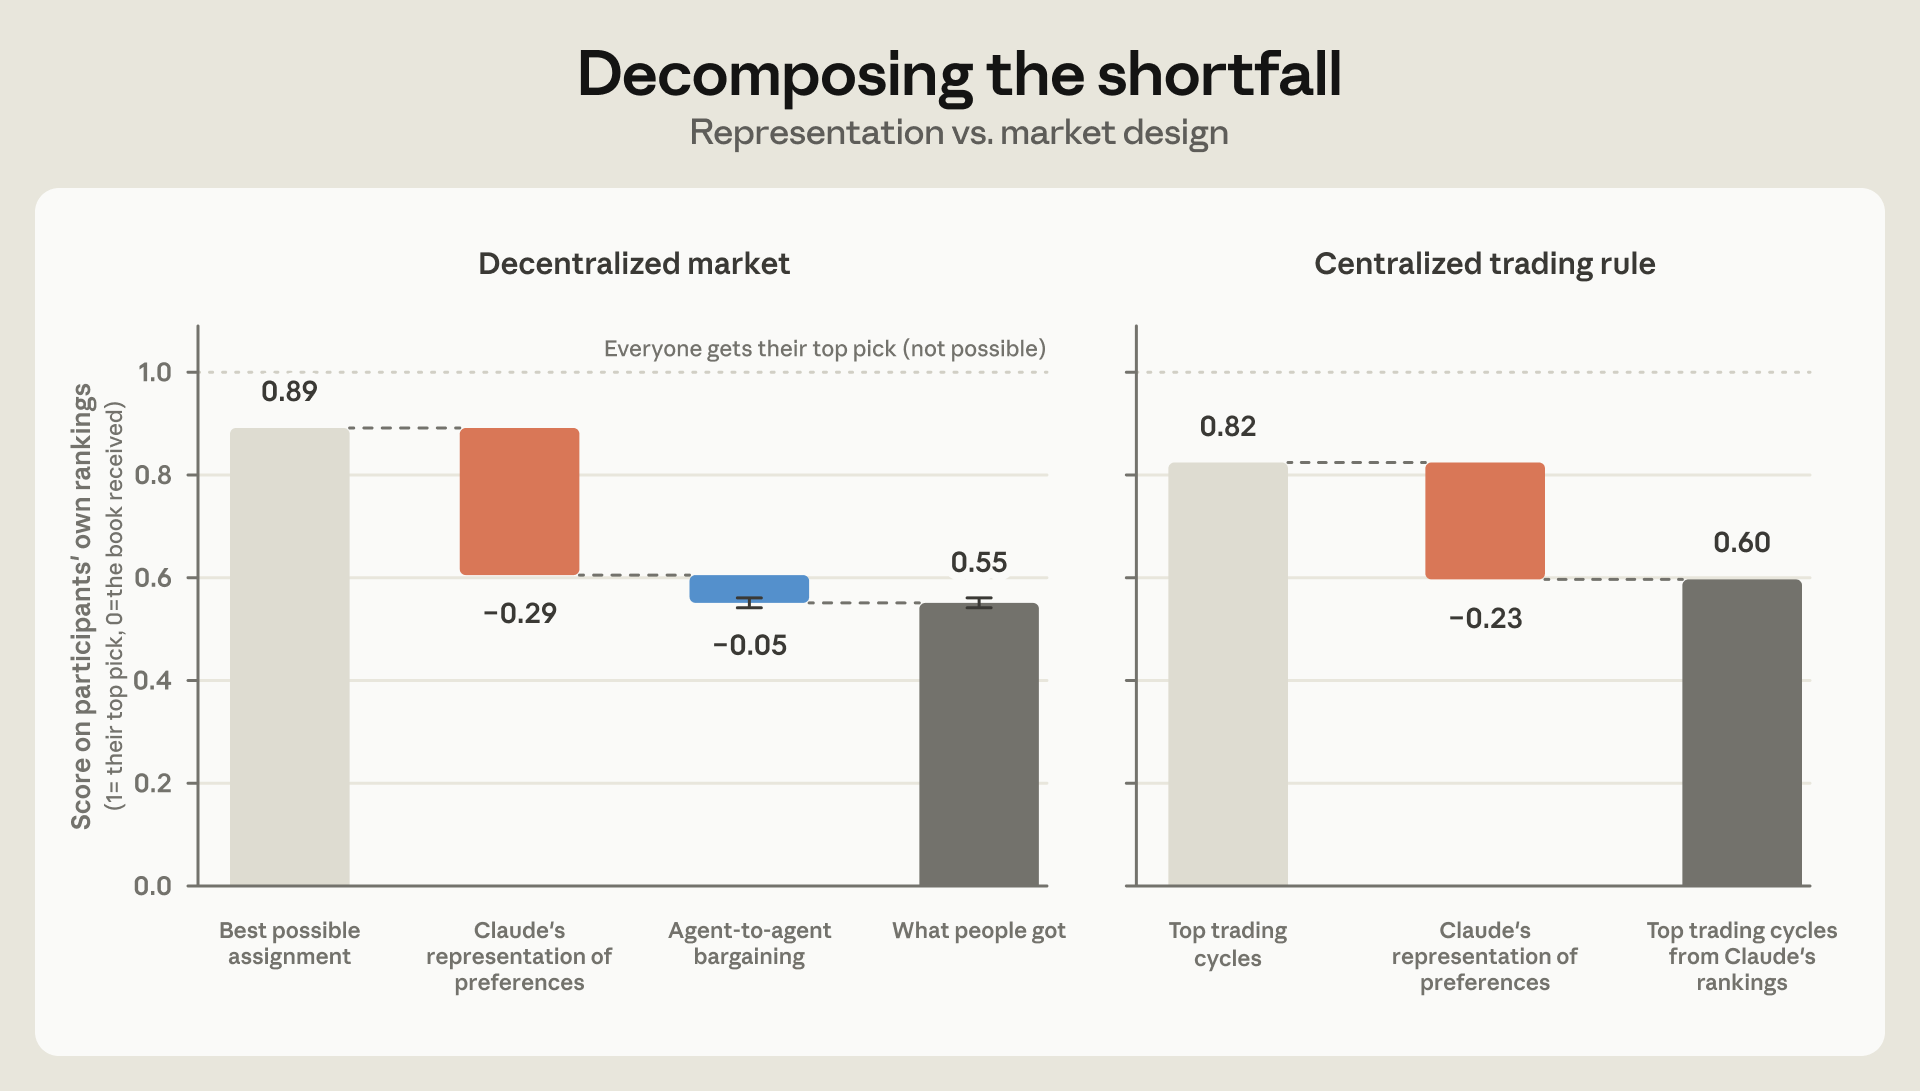
참가자가 받은 책은 본인 순위 기준 평균 0.55점, 10권 중 5위 수준이었습니다. 이론상 최선은 0.89점이었고, 격차의 85%는 선호 파악에서 생겼습니다.
나머지 15%는 협상에서 생겼고, 이 구간에서는 모델 등급이 프롬프트보다 큰 차이를 냈습니다. 에이전트 위임의 병목은 요구사항 전달입니다.
에이전트는 협상에서 크게 밀리지 않았습니다.
새는 곳은 원하는 것을 5분 만에 설명하려 한 주인 쪽입니다.
에이전트에게 거래를 맡길 때 흔히 협상 실력부터 걱정합니다. 상대에게 밀리지 않을지, 너무 쉽게 양보하지 않을지 묻습니다.
앤트로픽이 9월 24일 공개한 실험 결과는 달랐습니다. 직원 201명의 에이전트가 책을 두고 협상했는데, 손실 대부분은 협상 테이블 밖에서 났습니다. 주인이 무엇을 원하는지 에이전트가 충분히 알지 못했습니다.
에이전트가 사람 대신 사고파는 장면이 실험실 밖으로 나오고 있습니다. 앤트로픽은 지난 4월 Project Deal에서 직원들의 중고 거래를 에이전트에게 맡겼습니다. 그때는 물건이 제각각이라 결과가 최선에 얼마나 가까운지 잴 방법이 없었습니다. 이번 Project Swap에서는 책 교환이라는 단순한 시장을 만들어 그 거리를 쟀습니다. 구매나 협상을 에이전트에게 위임하려는 조직이라면 비용 누수 지점을 미리 점검할 수 있습니다.
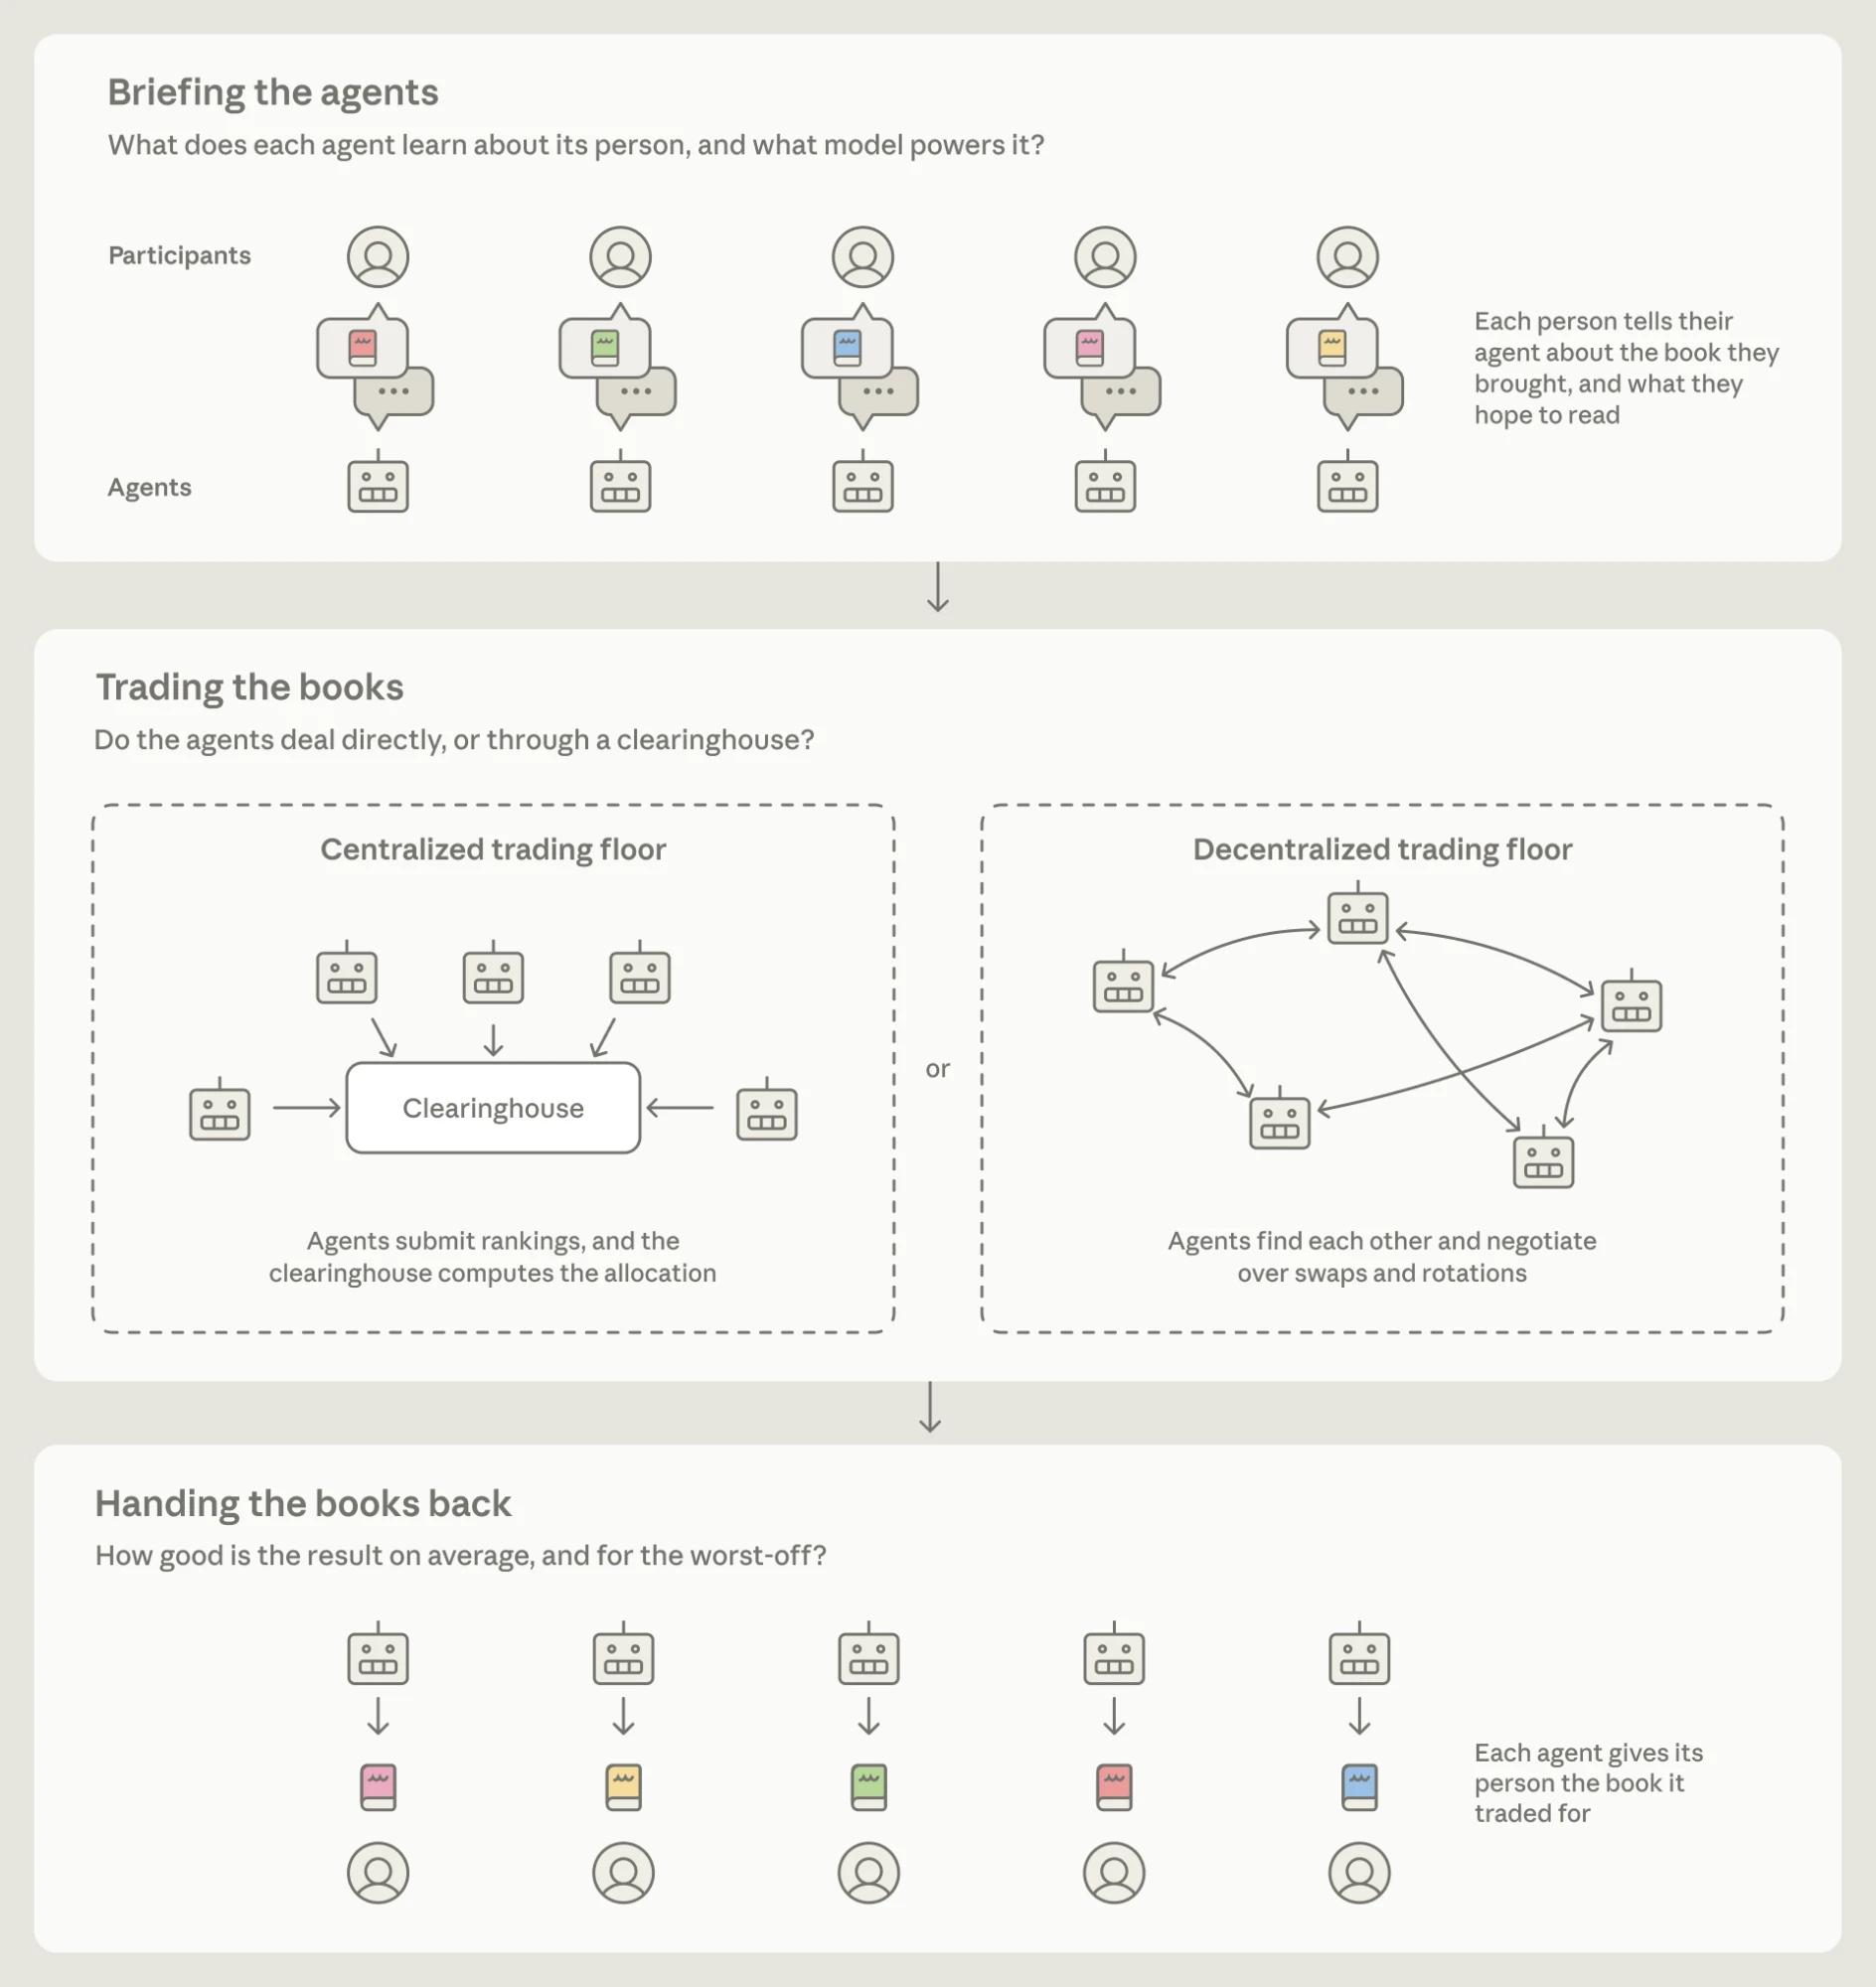
첫째, 실험은 대화, 거래, 채점의 세 단계로 진행됐습니다. 참가자는 샌프란시스코, 뉴욕, 런던 등 여섯 사무실의 직원 201명입니다. 각자 내놓을 책을 한 권씩 가져왔습니다. 클로드는 짧은 대화로 취향을 묻고, 같은 사무실 풀의 모든 책에 순위를 매겼습니다. 에이전트는 이 순위를 들고 공개 거래장에서 맞교환이나 여러 명이 도는 순환 거래를 협상했습니다.
참가자는 따로 자기 풀의 책 10권에 직접 순위를 매겼습니다. 에이전트는 이 정답 순위를 보지 못했고, 연구진은 이 순위로 결과를 채점했습니다. 참가자가 3명뿐인 더블린은 대부분의 분석에서 빠졌습니다.
둘째, 5분 대화로 맞힌 취향은 61%였습니다. 책 두 권을 짝지어 어느 쪽을 더 좋아할지 비교하면, 클로드의 순위와 본인 순위가 61% 일치했습니다. 무작위로 찍으면 50%입니다. 인기 순으로 줄 세우면 약 53%, 협업 필터링은 약 55%였습니다. 짧은 대화치고는 좋은 성적입니다. 그래도 열 쌍 중 네 쌍은 틀립니다.
| 선호 추정 방법 | 쌍별 일치율 |
|---|---|
| 무작위 추측 | 50% |
| 인기 순 정렬 (Open Library 읽고 싶어요 수) | 약 53% |
| 협업 필터링 (좋아한 책과 함께 평가된 책) | 약 55% |
| 클로드 (5분 대화 기반) | 61% |
출처: Anthropic (2026, September 24), 순위 제출자 188명 기준 재구성.
셋째, 더 많이 쓴 사람이 더 잘 대변됐습니다. 참가자 중앙값은 메시지 8개에 216단어를 썼습니다. 150단어 대신 300단어를 쓰면 일치율이 약 4%포인트 올라갔습니다. 무작위 추측과 클로드 평균 성적 사이 격차의 3분의 1에 해당하는 폭입니다.
넷째, 결과는 10권 중 5위 수준에 머물렀습니다. 채점 기준은 받은 책의 본인 순위였습니다. 1위 책이면 1점, 10위 책이면 0점입니다. 인기 책은 여러 명이 원하므로 모두가 1위를 받을 수는 없습니다. 샌프란시스코에서는 『프로젝트 헤일메리』를 1위로 꼽은 사람이 9명이었습니다.
이를 감안한 이론상 최선 배분이 0.89점, 대략 2위였습니다. 실제 평균은 0.55점, 대략 5위였습니다. 이 거리가 에이전트 시장이 놓친 몫입니다.
다섯째, 손실의 85%는 선호 파악에서 났습니다. 연구진은 격차를 두 조각으로 나눴습니다. 클로드가 추정한 순위로 최선 배분을 계산해 본인 순위로 채점하면 0.60점이 나옵니다. 0.89에서 0.60으로 떨어진 구간이 격차의 85%이고, 원인은 부정확한 순위입니다. 0.60에서 0.55까지 나머지 15%는 자유 협상에서 생겼습니다.
시장 설계를 바꿔도 크게 달라지지 않았습니다. 정직한 신고를 유도하는 중앙 배분 규칙인 탑 트레이딩 사이클도 클로드 순위로 돌리면 0.60점이었습니다. 입력된 선호가 부정확하면 거래 방식을 정교하게 다듬어도 개선 폭이 작습니다.
구매 업무에 대입해 보겠습니다. 구매 에이전트가 공급사와 흥정을 잘해도 소용없는 경우가 있습니다. 우리 팀이 품질과 납기 중 무엇을 우선하는지 모르면 엉뚱한 조건을 따냅니다. 협상 도구 선정보다 브리핑 점검이 먼저입니다.
| 배분 방식 | 사용한 선호 | 점수 (본인 순위 기준) |
|---|---|---|
| 이론상 최선 배분 | 본인 정답 순위 | 0.89 |
| 이론상 최선 배분 | 클로드 추정 순위 | 0.60 |
| 탑 트레이딩 사이클 | 클로드 추정 순위 | 0.60 |
| 에이전트 자유 협상 | 클로드 추정 순위 | 0.55 |
출처: Anthropic (2026, September 24). 0.89→0.60 구간이 선호 파악 몫(85%), 0.60→0.55 구간이 협상 몫(15%)입니다.
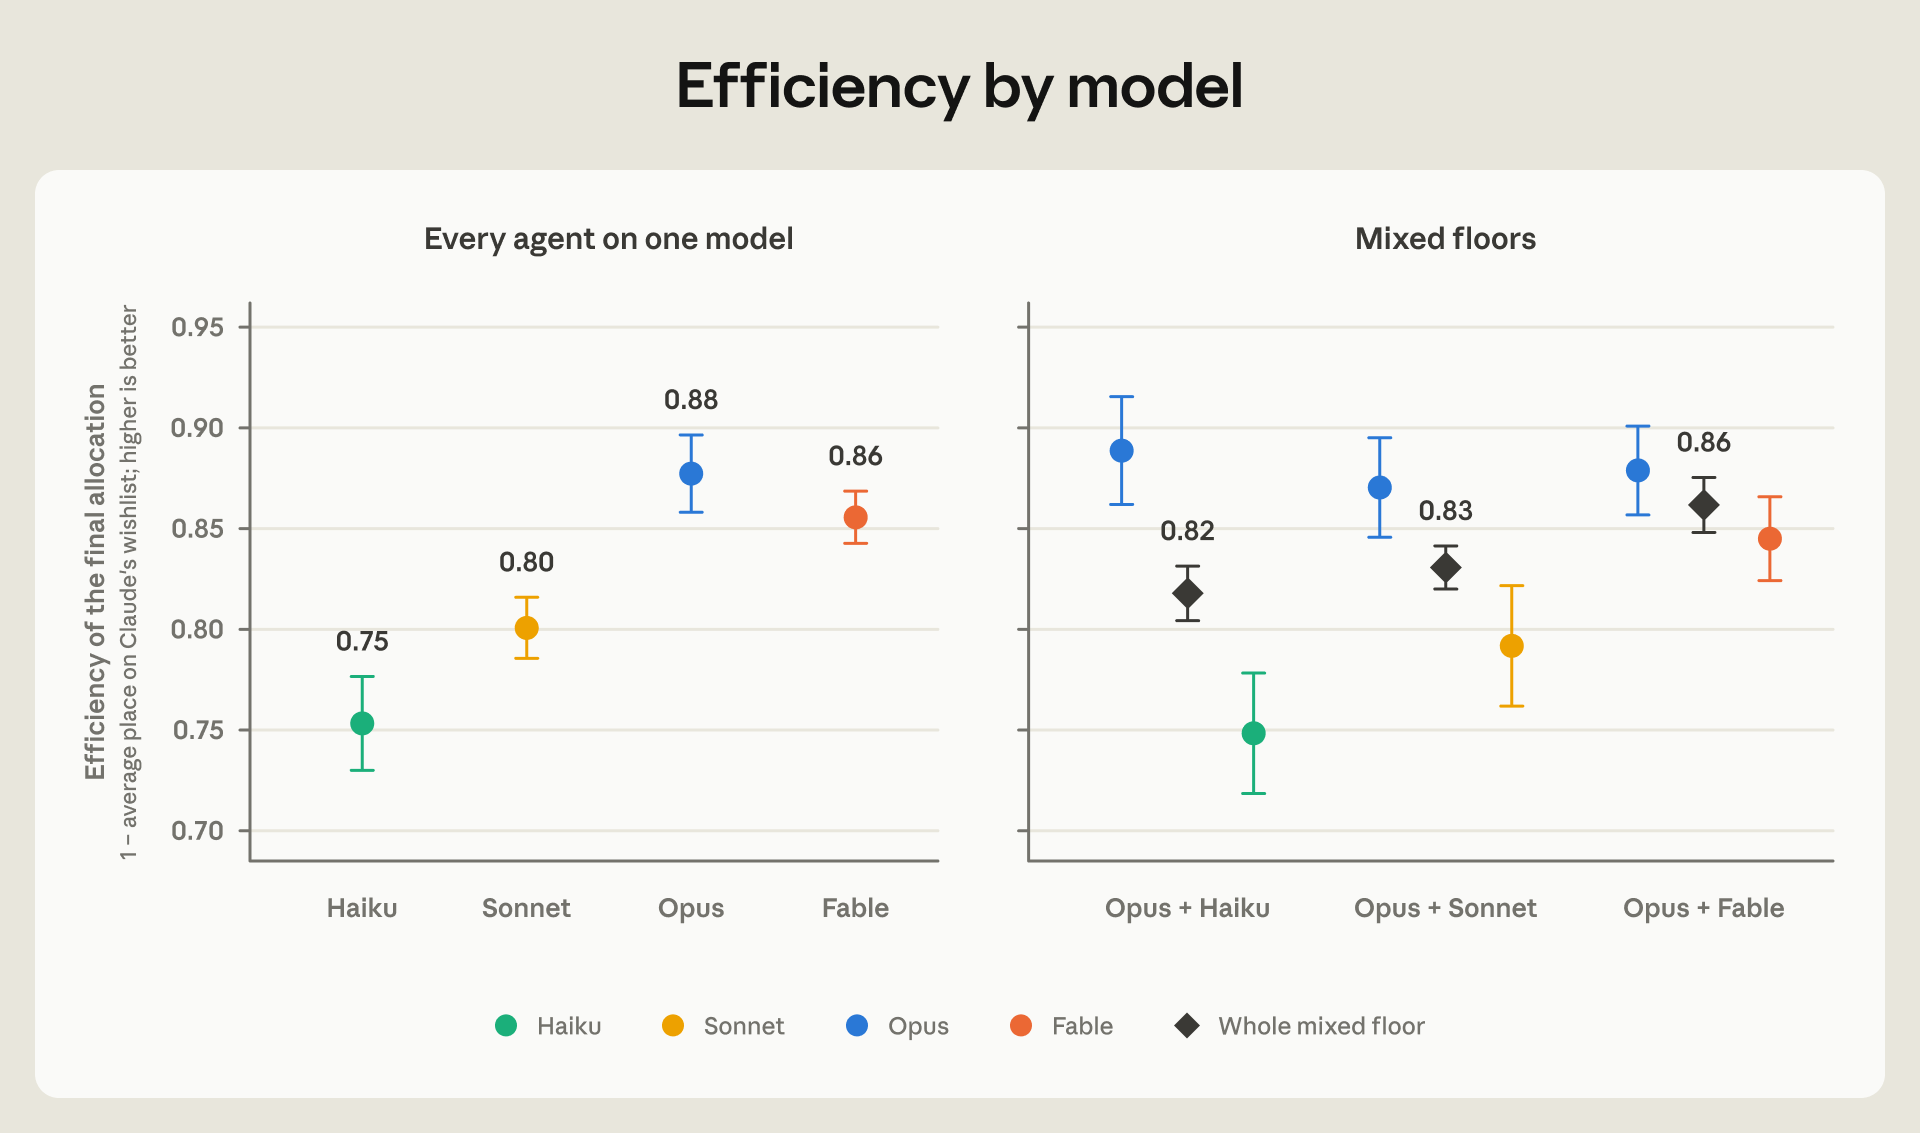
여섯째, 협상 단계에서는 모델 등급이 프롬프트보다 큰 차이를 냈습니다. 협상 효과만 보려면 채점 기준을 클로드 순위로 바꿔야 합니다. 이 기준의 최선은 0.95점입니다. 중립 지시로 돌린 거래장에서 하이쿠는 평균 0.75점, 오퍼스는 0.88점이었습니다. 소넷은 그 사이였고, 페이블은 오퍼스에 가깝지만 조금 낮았습니다.
하이쿠를 오퍼스로 바꾸면 점수가 0.12 올랐고, 소넷을 오퍼스로 바꾸면 0.08 올랐습니다. "무자비하게"라고 지시한 에이전트는 "친사회적" 에이전트보다 약 0.02 높았을 뿐입니다. 모델 교체 효과가 프롬프트 변경 효과보다 약 여섯 배 컸습니다. 절반씩 섞인 거래장에서는 오퍼스 쪽이 늘 앞섰습니다. 상대가 더 강한 모델을 쓰는 시장이라면 모델 등급이 곧 협상력입니다.
일곱째, 에이전트는 대체로 정직했고, 친사회적 에이전트는 가끔 양보했습니다. 모델에 따라 78~96%의 에이전트가 자기 1순위 책을 거래장에 밝혔습니다. 1순위를 밝히면 그 책을 가진 쪽의 협상력이 커지는데도 공개했습니다. 1순위를 밝힌 에이전트 가운데 거짓말을 한 에이전트는 약 100명 중 1명이었습니다.
연구진은 협상 전술 16가지를 찾아 압박, 홍보, 주선으로 묶었습니다. 압박 전술은 시간 제약이나 동료 의식에 기댑니다. 홍보 전술로는 경쟁 제안과의 비교, 수상 경력 강조가 쓰였습니다. 대기 명단 운영이나 남의 거래 중개는 주선 전술에 속합니다.
친사회적 에이전트가 순위 낮은 책을 받아들인 비율은 무자비한 에이전트의 두 배였습니다. 둘 다 드문 일이었지만, 한 참가자는 "동료 압박" 때문에 원하던 책을 내줬다며 불만을 남겼습니다.
여덟째, 요약이 정확하다고 느낀 사람이 더 많이 맡기겠다고 했습니다. 3주 뒤 설문에서 받은 책의 평균 만족도는 10점 만점에 7.2점이었습니다. 응답자 절반가량은 평소 직접 고른 책보다 낫다고 답했습니다. 연간 책 예산 중 에이전트에게 맡길 비율은 평균 약 30%였습니다. 취향을 잘 아는 친구에게 맡길 비율은 약 40%였습니다. 에이전트 신뢰도가 친구의 4분의 3 수준입니다.
참가자는 클로드가 쓴 한 문단짜리 대화 요약도 받았습니다. 요약에 "빠진 게 없다"고 답한 사람은 예산의 34%를 맡기겠다고 했습니다. "빠진 게 있다"고 답한 사람은 23%였습니다. 이해받았다고 느낀 사람일수록 위임 범위가 컸습니다.
아홉째, 연구진은 대리인 시험을 두 종류로 제안합니다. 사람 대리인도 자격시험을 봅니다. 증권 중개인은 Series 7, 투자자문가는 Series 65를 통과해야 합니다. 연구진은 AI 에이전트에게도 시험 두 개가 필요하다고 봅니다. 하나는 일반 역량을 인증하고, 다른 하나는 특정 개인을 제대로 이해했는지 확인합니다.
이번 실험의 10권 순위 비교가 두 번째 시험의 원형입니다. 에이전트가 내릴 결정 몇 개를 주인이 미리 확인하고, 어긋나면 정보를 보강하거나 위임을 철회하는 방식입니다. 조직의 점검 우선순위도 달라집니다. 협상 실력보다 에이전트가 우리 요구사항을 제대로 파악했는지가 먼저입니다.
과거에 직접 내린 결정 10건을 골라 에이전트에게 어떻게 골랐을지 먼저 답하게 하세요. 실제 선택과 일치한 건수를 세면 대변 수준을 수치로 확인할 수 있습니다. 일치율이 낮으면 위임 범위를 줄입니다. (30분, 이번 주)
이 실험에서 150단어와 300단어의 차이가 일치율 약 4%포인트였습니다. 원하는 것, 절대 안 되는 것, 이미 가진 것을 따로 적게 하세요. 참가자 불만 중 하나가 "이미 읽은 책을 받았다"였습니다. (양식 작성 1시간)
일을 맡기기 전에 이렇게 요청하세요. "지금까지 대화를 바탕으로 내가 원하는 것, 피하고 싶은 것, 판단 기준을 5줄로 요약해 줘. 확신이 낮은 항목은 따로 표시해 줘." 빠진 항목을 보충한 뒤 실행을 맡깁니다. (건당 5분)
한 참가자는 로그를 보고 에이전트가 한 시간 쥐고 있다 내준 책을 발견해 직접 샀습니다. 결과만 받으면 어디서 틀렸는지 알 수 없습니다. 반복 위임하는 업무라면 주 1회 로그 검토 시간을 잡으세요. (주 30분)
참가자가 앤트로픽 직원입니다. 클로드 개발에 참여한 사람이 많아 일반인보다 AI 신뢰도가 높을 가능성이 큽니다. 연구진도 예산의 30%를 맡기겠다는 답이 일반 인구보다 높을 수 있다고 밝혔습니다.
정답 순위 자체에 잡음이 있을 수 있습니다. 순위를 성실히 매길 금전적 인센티브가 없었습니다. 순위 과제 참여율은 95%였지만 마지막 설문 응답률은 59%에 그쳤습니다.
공손한 에이전트만 참여했습니다. 모든 에이전트가 협조적으로 학습된 클로드 모델이었습니다. 남을 속이도록 만든 에이전트가 섞이면 효율과 공정성 결과가 달라질 수 있습니다. 연구진은 거래 시간, 동시 발언 수 같은 시장 규칙도 고정했습니다.
줄일 수 없는 오차도 있습니다. 한 참가자는 책에 관해서라면 자신도 원하는 것을 다 알지 못한다고 적었습니다. 대화를 길게 해도 선호 파악 오류가 0이 되지는 않습니다. 책보다 조건이 복잡한 채용이나 구매에서는 이 오차가 더 커질 수 있습니다.
거래 불이행에 대비한 규칙이 없었습니다. 책을 가져오지 않은 참가자가 있어 일부는 빈손으로 돌아갔고, 연구진은 누구 책임인지 추적하지 못했습니다. 실제 시장이라면 신원 확인, 환불 규칙, 발언 횟수 제한이 먼저 필요합니다.
에이전트의 협상 실력은 준수했습니다. 손실은 사람의 요구사항을 에이전트에게 전달하는 첫 단계에서 났습니다.
쌍별 일치율: 책 두 권씩 짝지어 어느 쪽을 더 좋아하는지 비교했을 때, 두 순위가 같은 답을 낸 비율입니다. 무작위로 찍으면 50%입니다.
협업 필터링: "X를 좋아한 사람은 Y도 좋아했다"는 공개 데이터로 취향을 추정하는 추천 방식입니다.
이론상 최선 배분: 모두의 진짜 선호를 안다고 가정하고 전체 만족도가 가장 높게 책을 나누는 배분입니다. 경제학에서는 공리주의적 최적이라고 부릅니다.
탑 트레이딩 사이클: 각자 가장 원하는 물건을 지목하고, 지목이 원을 이루면 그 안에서 교환을 확정하는 중앙 배분 규칙입니다. 거짓 신고로 이득을 볼 수 없도록 설계됐습니다.
분산형 시장: 중앙 관리자 없이 참가자끼리 상대를 찾아 직접 협상하는 시장입니다. 이번 실험의 거래장이 여기에 해당합니다.
친사회적 / 무자비한 지시: 연구진이 에이전트에게 준 두 가지 지시문입니다. 무자비한 에이전트는 주인의 만족만, 친사회적 에이전트는 모두의 만족도 함께 신경 쓰도록 지시받았습니다.
- Hitzig, Z., Carr, S., Cotter, T., Troy, K., Turman, K., Massenkoff, M., & McCrory, P. (2026, September 24). Project Swap: What happens when agents trade for us? [Article]. Anthropic. (원문 보기 ↗)
- Troy, K. K., Shields, D., Bradwell, K., & McCrory, P. (2026, April 24). Project Deal: Our Claude-run marketplace experiment [Article]. Anthropic. (원문 보기 ↗)