
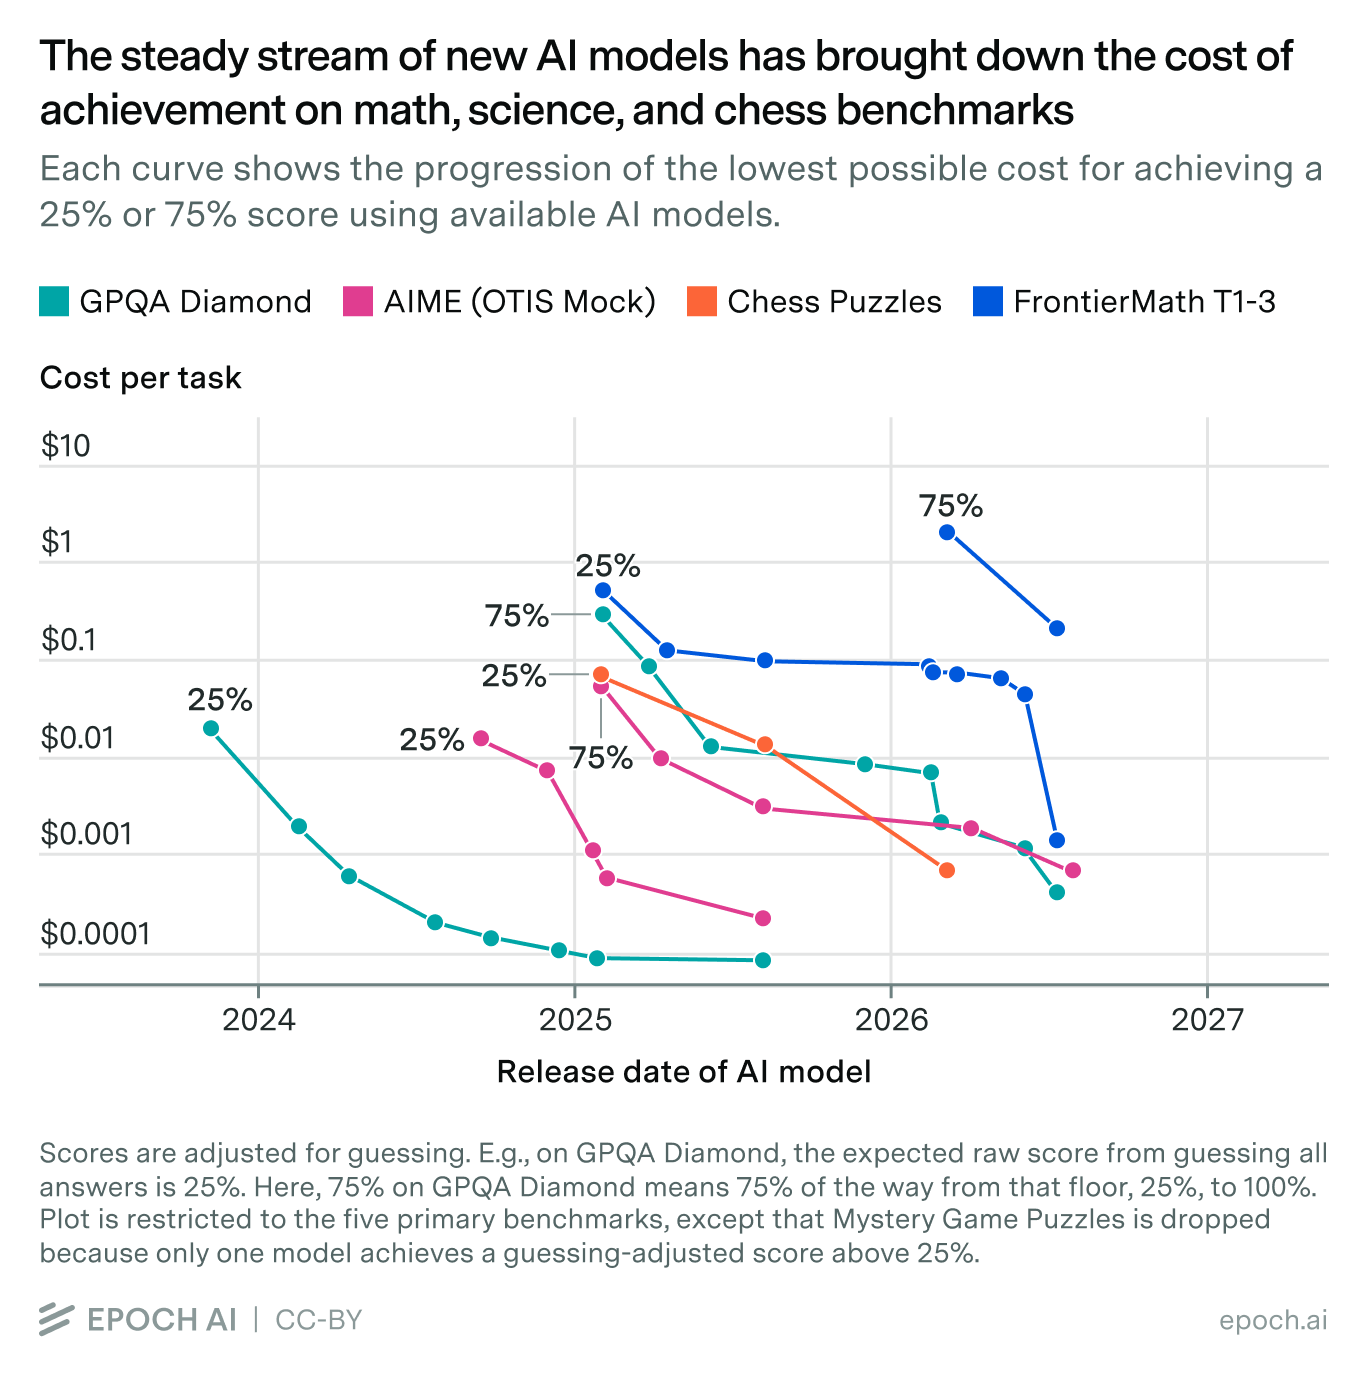
같은 AI 성능을 얻는 비용이 2023년 이후 분기마다 약 47% 내려갔습니다. 1년으로 치면 13분의 1입니다.
GPQA Diamond 75% 점수의 문항당 비용은 0.30달러에서 0.0004달러가 됐습니다. 18개월이 채 안 걸린 725분의 1 하락입니다.
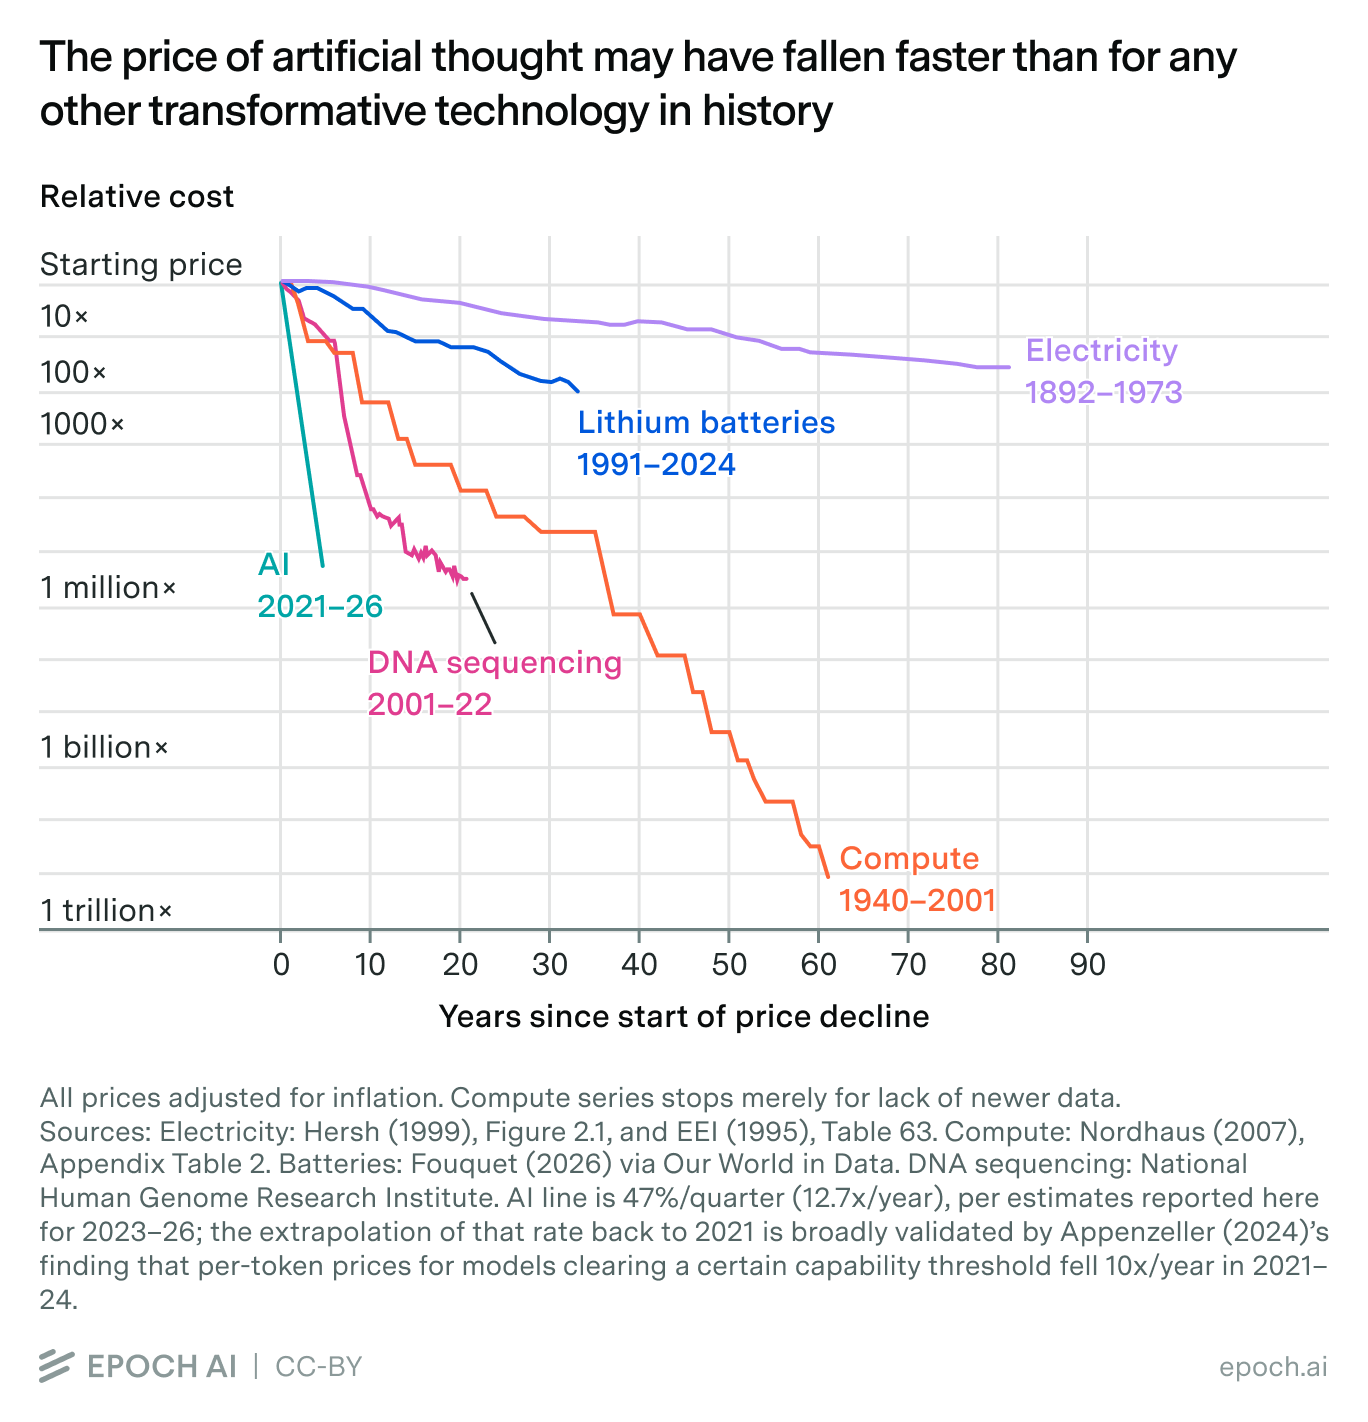
이 속도는 DNA 시퀀싱의 4배, 전기의 54배입니다. 연 단위 고정 단가로 AI 예산을 짜고 ROI를 산정하는 방식은 이제 맞지 않습니다.
AI 사업계획의 단가를 작년 견적으로 쓰고 계십니까?
지금 시세보다 열세 배 비싼 단가입니다.
2025년 1월 31일 오픈AI가 o3를 내놨습니다. 박사급 과학 시험인 GPQA Diamond에서 75%를 맞히는 데 문항당 약 30센트가 들었습니다.
18개월이 채 안 돼 나온 GPT-5.6 Luna는 같은 점수를 0.0004달러에 냈습니다. 에포크 AI는 이를 5만 달러짜리 새 차 가격이 69달러로 내려간 셈이라고 비유했습니다. 작년에 "비싸서 보류"한 AI 과제가 있다면, 그 판단의 근거가 된 숫자는 이미 바뀌었습니다.
AI 붐이 칩, 전력, 전기 기술자의 인건비까지 끌어올리는 동안 에포크 AI는 반대편 지표에 주목했습니다. 데이터센터 산출물의 단가는 빠르게 떨어지고 있습니다. 그런데 기업의 AI 예산 논의는 대체로 투입 비용 상승에 초점이 맞춰져 있습니다. 같은 업무의 처리 비용이 1년에 13분의 1로 준다는 사실은 예산안에 좀처럼 반영되지 않습니다. 4분기에 내년 예산을 편성하는 리더라면 이 격차부터 점검해야 합니다.
첫째, 에포크 AI는 토큰 단가 대신 성과 단가를 쟀습니다. 이전 분석은 일정 점수를 넘는 모델의 토큰당 가격을 비교했습니다. 추론 모델은 토큰 사용량이 훨씬 많아서 이 방식으로는 실제 비용이 가려집니다. 이번 분석은 한 문항을 푸는 데 실제로 든 비용을 산정했습니다. 연구진은 모델별로 토큰 예산을 바꿔 가며 점수 곡선을 그렸습니다. 그리고 점수 구간마다 가장 싼 모델을 골랐습니다.
둘째, 다섯 벤치마크의 평균 하락률은 분기당 47%입니다. 연구진은 2023년부터 수학, 과학, 게임 세 영역을 추적했습니다. 수학에는 AIME OTIS Mock과 FrontierMath 1~3단계를, 과학에는 GPQA Diamond를 썼습니다. 게임 영역에는 체스 퍼즐과 비공개 게임 퍼즐이 들어갑니다.
하락 속도는 영역마다 달랐습니다. 수학이 분기당 50~52%(연 16~19배)로 가장 빨랐습니다. 게임 퍼즐은 39~43%(연 7~10배)로 가장 느렸지만, 그래도 1년 새 비용이 7분의 1로 줄었습니다.
셋째, 다른 범용 기술보다 훨씬 빨리 싸지고 있습니다. 에포크 AI는 연간 하락 배율을 다른 기술과 나란히 놓았습니다. 로그 기준으로 AI 추론은 DNA 시퀀싱보다 4배, 컴퓨팅보다 6배 빨리 싸졌습니다. 리튬이온 배터리와 비교하면 18배, 1973년까지 약 100년간의 전기와 비교하면 54배입니다. 연구진은 이를 범용 기술 가운데 가장 빠른 가격 하락일 수 있다고 적었습니다.
| 기술 | 기간 | 연간 가격 하락 배율 |
|---|---|---|
| AI 추론 (같은 성능 기준) | 2023~2026 | 13배 |
| DNA 시퀀싱 | 2001~2025 | 1.84배 |
| 컴퓨팅 | 1940~2001 | 1.51배 |
| 리튬이온 배터리 | 1991~2024 | 1.16배 |
| 전기 (미국 가정용) | 1892~1973 | 1.05배 |
출처: Epoch AI (2026, September 22), 결론부 재구성.
넷째, 가장 비싼 구간이 가장 빨리 싸집니다. 어떤 점수를 처음 달성한 직후에는 비용이 분기당 66%(연 75배) 떨어졌습니다. 2년이 지난 뒤에는 분기당 32%(연 4.7배)로 하락 속도가 절반이 됐습니다. 연구진은 이를 이렇게 해석합니다. 새 최고 모델을 낸 회사가 잠시 프리미엄을 받다가 경쟁과 기술 개선에 밀려 가격을 내린다는 것입니다. 최고 성능 근처의 가격 경쟁은 주로 비공개 가중치 모델 사이에서 일어났습니다.
구매 판단에 대입하면 이렇습니다. 최신 모델 출시 첫 분기의 대량 계약은 프리미엄 구간에서 사는 일입니다. 반면 한두 분기 전 최고 성능으로 충분한 업무라면 단가가 이미 크게 내려와 있습니다. 모델 선정 기준도 달라집니다. "가장 좋은 것"보다 "이 업무에 충분한 것 중 가장 싼 것"을 묻는 편이 낫습니다.
다섯째, 이 속도는 2021년부터 이어졌을 가능성이 큽니다. GPT-3는 MMLU 43.9점에 가격이 100만 토큰당 60달러였습니다. 2023년 7월 나온 메타의 Llama 2-7B는 45.3점을 0.20달러에 냈습니다. 연구진은 두 모델을 비교해 연 31배 하락을 산출했습니다.
추론 모델 이전 세대라 두 모델의 토큰 사용량은 비슷했다고 가정했습니다. 연구진은 이를 근거로 연 13배 이상의 하락이 약 5년간 이어졌다고 추정합니다. 따라서 예산에 단가 하락을 반영하는 근거는 3년치 데이터에 그치지 않습니다.
원문 수치를 그대로 곱해 보면 규모가 잡힙니다. GPQA 75% 수준의 문항 100만 건을 처리한다고 가정합니다. o3 출시 당시 단가로는 약 30만 달러가 들고, GPT-5.6 Luna 단가로는 약 400달러면 됩니다.
분기당 47% 하락이 이어진다면 지금 단가는 1년 뒤 약 13분의 1이 됩니다. 연초 단가로 12개월 사업계획을 고정하면 하반기 비용이 과다 계상됩니다. ROI가 낮게 잡혀 통과할 수 있던 과제가 탈락합니다. 공급 계약도 같습니다. 단가를 1년 이상 고정하면 하락분은 벤더 몫이 됩니다.
지난 1년간 "비용이 안 맞는다"로 멈춘 과제를 적고, 당시 견적 단가와 날짜를 옆에 쓰세요. 견적이 두 분기 이상 지났다면 다시 견적을 받으세요. 팀장 한 명이 반나절이면 목록을 만들 수 있습니다. (이번 주)
비용을 고정 단가 한 줄 대신 시나리오 세 줄로 계산하세요. 분기 단가 유지, 분기 30% 하락, 분기 47% 하락입니다. 클로드에 이렇게 요청하면 됩니다. "이 AI 과제의 12개월 비용표를 분기별로 만들어줘. 현재 월 비용은 ○○원이야. 분기 단가 하락 0%, 30%, 47% 세 시나리오로 누적 비용과 회수 시점을 비교해줘." (30분)
실제 업무 20~50건과 합격 기준을 한 파일로 묶으세요. 새 모델이 나오면 이 시험지로 점수와 건당 비용을 함께 재세요. 에포크 AI의 하락률은 늘 가장 싼 모델로 갈아타는 사용자를 가정합니다. 갈아타지 않으면 그만큼의 비용 절감도 없습니다. (첫 구축 1주, 이후 분기 1일)
AI 공급 계약이 12개월 이상이면 분기별 단가 재검토나 최신 모델 전환 조항을 요구하세요. 최신 모델이 나온 첫 분기에는 대량 선결제를 피하세요. 가격이 가장 높고, 가장 빨리 떨어지는 시기입니다. (다음 계약 갱신 시)
벤치마크 점수는 실제 업무 성과와 다릅니다. 연구진이 가장 먼저 단 경고입니다. AI 회사가 공개 벤치마크에 맞춰 모델을 학습시키면 점수 개선이 실무 개선보다 커집니다. 문제를 공개하지 않은 게임 퍼즐의 하락률은 분기당 44.0%로 평균 47.0%보다 조금 낮았습니다. 연구진은 이 결과를 두고 벤치마크 과적합 비판이 타당하되 치명적이지는 않다고 봤습니다.
실제 사용자는 이만큼 아끼지 못합니다. 이 분석은 과제마다 가장 싼 모델을 찾아 끊임없이 갈아타는 사용자를 가정합니다. 연구진은 실제 사용자가 그렇게 자주 모델을 바꾸지 않는다고 명시했습니다. 회사의 실제 절감률은 교체 주기와 전환 비용에 달려 있습니다.
데이터 기간이 짧고 평균 방식에 따라 숫자가 달라집니다. 주요 데이터는 약 3년치입니다. 점수 구간을 평균하는 방식만 바꿔도 분기당 하락률이 42.9%에서 58.0% 사이로 움직입니다. 47%는 방향과 규모를 가늠하는 참고치입니다. 예산표에는 단일 수치보다 범위로 넣는 편이 안전합니다.
"생각의 값"은 전기처럼 한 가지 상품이 아닙니다. 연구진은 AI 추론이 계속 바뀌는 서비스 묶음이라서 전기 1킬로와트시처럼 비교하기 어렵다고 인정했습니다. 다른 기술과의 배율 비교에도 성격이 다른 대상을 견주는 한계가 있다고 스스로 적었습니다.
단가 하락이 총지출 감소를 뜻하지는 않습니다. 건당 비용이 내려가면 더 많은 업무에 AI를 쓰게 됩니다. 사용량이 늘면 총액은 오히려 커질 수 있습니다. 예산은 총액보다 건당 비용과 건당 가치의 차이를 기준으로 관리해야 합니다.
같은 성능의 AI는 1년에 13분의 1로 싸집니다. AI 예산은 고정 단가 대신 분기마다 재산정하는 숫자로 다뤄야 합니다.
추론 비용: 학습이 끝난 AI 모델에 일을 시킬 때 드는 비용입니다. 이 글에서는 한 문항을 푸는 데 드는 돈을 뜻합니다.
GPQA Diamond: 박사급 물리·화학·생물 문제로 구성된 객관식 시험입니다. AI의 과학 추론 능력을 재는 데 널리 쓰입니다.
추론 모델: 답을 내기 전에 긴 사고 과정을 거치는 모델입니다. 토큰을 많이 쓰는 대신 작은 모델로도 높은 점수를 냅니다.
토큰 예산: 모델이 한 문항에 쓸 수 있는 출력 토큰의 상한입니다. 예산을 줄이면 비용과 점수가 함께 내려갑니다.
파레토 프런티어: 각 점수를 가장 싸게 내는 모델들을 이은 선입니다. 에포크 AI는 이 선이 시간에 따라 내려가는 속도를 쟀습니다.
SOTA(최고 성능): 특정 시점에 어떤 벤치마크에서 가장 높은 점수를 낸 수준입니다.
벤치마크 과적합: AI 회사가 공개 시험 점수에 맞춰 모델을 학습시켜 실제 능력보다 점수가 높아지는 현상입니다. 원문은 "benchmaxxing"이라고 부릅니다.
- Emberson, L., & Roodman, D. (2026, September 22). The plunging price of thought [Report]. Epoch AI. (원문 보기 ↗)